
フィボナッチとピボットの有効性を検証する方法|反応率・期待値・過剰最適化
「フィボナッチは効くのか」「ピボットは機能するのか」という問いは、そのままの形では検証できません。この問いの中には、少なくとも四つの別の問いが折り畳まれているからです。価格がその水準で反応したか。他の価格帯より反応しやすかったか。その反応を売買へ変換したとき、コストを引いた後に何かが残ったか。そして、条件を決めるのに使っていない期間でも同じことが起きたか。この四つは後ろへ行くほど強い主張で、前の問いに「はい」と答えられても次の答えは決まりません。四段を一つの言葉でまとめれば、どの段の証拠も持たないまま「有効だ」あるいは「無効だ」と言うことになります。
読み終えると、手元の集計や他人の検証結果について、それが四段のどの段の証拠なのかを判定し、比較対象、分母の置き方、定義の固定、コストの見積もり、標本の分け方、試行回数の記録、推定の幅のどこが欠けているのかを指摘できるようになります。既存の実証研究も二本引き、それぞれが何を確立し、何を確立していないかを、対象・期間・比較群まで含めて示します。
本記事は、フィボナッチやピボットが有効かどうかを答えません。どの比率やどの水準が有効かという結論も出しません。代わりにできるのは、その問いに答えようとするとき、何をどう測れば出てきた数字が意味を持つのかという設計の側を固定することです。
参入や退出、注文の置き場所、数量といった売買の設定は扱いません。本記事に出てくる数値は、引用した学術研究の報告値を除き、すべて説明のために作った合成値です。実在の銘柄や期間の成績ではなく、将来の成績を示すものでもありません。また、本記事が引く実証研究二本は設計が互いに異なるため、「実証研究によれば」という形で束ねることはしません。ここで扱う水準はいずれも観察の候補であり、価格の方向を決めるものでも、反発や到達を保証するものでもありません。実際の判断は、ご自身の責任において行ってください。
四つの問いは、それぞれ何を分母にしているのか
第一段の反応は、事前に決めた条件で価格が観察点へ到達し、事前に決めた条件で反対方向へ動いたかを数えます。得られるのは、その定義のもとでの割合だけです。第二段の相対反応は、同じ定義、同じ条件で作った比較群と比べて対象群の割合が高いかを見ます。ここで初めて、その水準に固有の何かがあるかという問いに触れます。第三段の売買利益は、反応を売買へ変換し、平均利益、平均損失、取引コストを含めた1取引あたりの平均を計算します。ここで初めて金額の話になります。第四段の再現性は、条件を決めるのに使っていない期間へ、条件を変更せずに適用して同じ方向の結果が出るかを見ます。
反応率は到達を分母にする
例を置きます。以下は合成値です。
到達(事前に定義した到達条件を満たした事例)   400 回
反応(事前に定義した反応条件を満たした事例)   236 回

反応率 = 236 ÷ 400 = 0.590 = 59.0%
この 59.0% が述べているのは、事前に決めた到達条件を満たした 400 件のうち、事前に決めた反応条件を満たしたものが 236 件あった、という一文だけです。
勝率と期待値は取引を分母にする
別の例を置きます。単位は値幅(pips 等)とし、通貨や銘柄は特定しません。
勝率      0.40
平均利益  20
平均損失  10

コスト控除前の期待値
  E = 0.40 × 20 − 0.60 × 10 = 8.0 − 6.0 = 2.0

往復コスト 1.0 を控除
  E_net = 2.0 − 1.0 = 1.0
平均利益 20 と平均損失 10 は、期待値という式の構造を示すために置いた枠組みの例であって、読者が使うべき値ではありません。この例では勝率が 40% でもコスト控除後の平均はプラスですが、勝率が 70% でも平均損失が平均利益を大きく上回れば期待値はマイナスになります。勝率は期待値の一部でしかありません。
59.0% と 40% は比較できない:指標と分母の対照
反応率 59.0% と勝率 40% は、同じ観察点を扱っていても比較できません。分母も事象も違うからです。
分母の側では、到達した 400 件がそのまま 400 取引になるわけではありません。到達したが参入条件を満たさなかった事例、参入したが観測窓の中で利益目標にも損失限定の幅にも届かなかった事例、記録の対象期間が先に終了した事例が、どこかで抜けます。事象の側では、反応の判定が値動きそのものに対するものであるのに対し、勝ちの判定はコストと約定を含む取引結果に対するものです。反応の定義を満たした事例が、参入価格とコストの関係によって損失で終わることは普通に起こります。
したがって、反応率が高いことは勝率が高いことを意味せず、勝率が高いことは期待値が正であることを意味せず、期待値が正であることはコスト控除後も正であることを意味しません。
| 指標 | 分子 | 分母 | 数えている事象 | この数字だけでは言えないこと |
|---|---|---|---|---|
| 反応率 | 反応の定義を満たした事例(例では 236) | 到達の定義を満たした事例(例では 400) | 観察点へ到達した後、観測窓の中で反応の定義を満たしたか | 他の価格帯より反応しやすいか。反応が売買の損益になるか |
| 相対反応 | 対象群の反応率と比較群の反応率の差 | 各群の到達件数を別々に数える | 同じ定義、同じ条件で作った比較群に対する差 | その差が金額として残るか。他の市場や時間足でも同じ差が出るか |
| 勝率 | 利益で終えた取引の件数 | 成立した取引の件数 | 参入から決済までを終えた取引のうち、利益で終えた割合 | 期待値が正か。1取引あたりいくら残るか |
| 期待値 | 全取引の損益合計 | 取引件数 | 勝率、平均利益、平均損失をまとめた1取引あたりの平均 | コストを引いた後も正か。推定にどれだけ幅があるか |
| コスト控除後期待値 | 全取引の損益合計から取引コストを差し引いた額 | 取引件数 | 実際に支払う費用を含めた1取引あたりの平均 | 想定したコストが実際と合っているか。将来も同じ値になるか |
| 再現性 | 条件決定に使っていない期間で得られた成績 | その期間の取引件数 | 条件を変更せずに未使用期間へ適用した結果 | 将来の成績。次の期間でも同じ結果になること |
最後の行だけ性質が異なります。再現性は単独の指標ではなく、上の指標を別の期間で計算し直す条件です。
二本の実証研究は、何を報告し、何を報告していないのか
以下の二本は、それぞれの設計の内側でのみ成立する報告です。どちらも、フィボナッチやピボットが一般に有効である、あるいは無効であるという結論を出していません。多数の条件を試したときに数字がどう見えるかという評価の枠組みは、「何通り試したかを数えないと、何が起きるのか」で扱います。
Osler (2000)
対象は外国為替スポットの3通貨ペア、対米ドルのドイツマルク、日本円、英ポンドです。株式は扱っていません。頻度は1分足で、ニューヨーク時間9時から16時までを対象としています。期間は1996年1月から1998年3月で、論文自身はこれを28か月の標本と記述しています。素直に数えると27か月になりますが、ここでは原文の表記に従います。データは Reuters の気配値です。
検証対象は、業者6社が実際に顧客へ配信した支持線・抵抗線そのものです。これらの水準の由来には、視覚的な判定、数値ルール、注文に関する情報、市場心理が混在しています。フィボナッチ水準の検証ではありません。同論文がフィボナッチに触れるのは、アナリストが用いる入力の一例として列挙する1箇所のみです。計算式から求めるピボットの検証でもありません。比較対象は、一様乱数で生成した人工的な支持線・抵抗線を1日あたり10,000セット作ったもので、統計手法は二項検定です。
確立していることは次の点です。上記の市場、時間足、期間において、公表された水準の反発頻度は 60.8%、人工水準では 56.2% であり、16 の「業者 × 通貨」の組合せすべてで公表水準が上回りました。5% 水準で有意だったのは 13 組です。全社が3通貨すべてを配信していたわけではないため、組合せは 18 ではなく 16 です。
同時に、確立していないことがあります。第一に、60.8% という絶対値は反発の起きやすさの水準を示しません。著者自身が、ランダムウォークでも理論上およそ 50% になること、および定義上の非対称性とデータの負の自己相関により 50% を超える構造があることを説明しています。意味を持つのは人工水準との差、およそ 4.6 ポイントです。
第二に、結果は期間に依存します。標本を時系列で二分すると、ボラティリティが低かった前半ではほぼすべての組合せで有意でしたが、通常の水準へ戻った後半では、半数のケースで有意性が消失しました。同じ市場、同じ手法でも、期間を分ければ結論が変わったということです。
第三に、取引コストを扱っておらず、収益性を検証していません。著者は結論部で、継続的に利益を得られるかを調べるのが自然だが、それは今後の研究の主題であると明言しています。
Tsinaslanidis, Guijarro & Voukelatos (2022)
対象は株式個別銘柄160社(ダウ30、NASDAQ100、DAX30)です。為替は扱っていません。頻度は日足の4本値、期間は1968年1月から2019年3月までの50年超、データは Bloomberg です。
検証対象は、アルゴリズムで自動生成したフィボナッチ押し水準4本(100%、61.80%、38.20%、23.61%)です。局所的な高値・安値を識別する規則と、先行するトレンドの定義が完全に明示されており、裁量的な引き直しの余地がない設計になっています。各水準には幅 ζ を与えてゾーン化し、ζ は 0%、2%、4%、6% を試しています。比較対象は、フィボナッチ水準から十分に離れた位置に置いた無作為の非フィボナッチゾーンで、ロジット回帰とブートストラップ500回で評価しています。
確立していることは次の点です。ζ が 0%、2%、4% のいずれにおいても、フィボナッチゾーンと非フィボナッチゾーンの反発確率に統計的に有意な差は確認されず、信頼区間は一貫してゼロを含みました。ζ = 6% では係数が有意に負となり、著者は、広いゾーンではむしろ非フィボナッチゾーンで反発しやすいと解釈しています。売買ルールとしても、保有1日から21日、コスト控除前の条件で、非フィボナッチのベンチマークを上回りませんでした。そして、ゾーン幅を広げると反発確率はダウの銘柄で 49.08%(ζ = 0)から 73.23%(ζ = 6%)へ単調に上がるものの、それは反発・失敗の定義の非対称性による機械的な効果であり、収益性の向上には結びつかない、と著者自身が明記しています。
確立していないことも明確です。この結果は株式の日足に関するものであり、為替、日中の時間足、他の指標との併用、異なる高値・安値の判定規則については検証されていません。著者の結論は、単独のテクニカル売買ツールとしては、という限定付きです。取引コストは扱われておらず、本文に該当する語が出現しません。
二つを一文で束ねない
以上から、二つの研究を「実証研究によれば」という一文でまとめることはできません。市場が違い、時間足が違い、期間が違い、検証対象が違い、比較群の作り方も統計手法も違います。
したがって、株式・日足の結果を為替や他の時間足へ一般化することはできません。逆に、外国為替の1分足で得られた結果を株式の日足へ持ち出すこともできません。そして、どちらの研究も「フィボナッチやピボットは有効である」あるいは「無効である」という普遍的な結論を出していません。それぞれの主張は、それぞれの設計の内側にとどまります。
比べる相手を置かないと、その割合は何を意味するのか
単独の割合は解釈できない
反応率 59.0% は、比較対象がなければ何も主張しません。価格は一方向へ進み続けるわけではなく、上下しながら動きます。ある水準の反応率が 50% を超えたという観察は、その水準に固有の性質を示しているとは限りません。判定の緩さと、価格系列そのものの性質の両方が、その数字を押し上げているからです。判定の緩さがどう効くかは、「判定の緩さが数字を押し上げる」で扱います。意味を持つのは絶対値ではなく、同じ定義、同じ条件で作った比較群との差です。
比較群にそろえる項目
比較対象には、無作為に生成した水準、フィボナッチ比率ではない比率、あるいは同じ距離条件を満たす別の価格などが使えます。どれを使う場合でも、対象群とそろえるべき項目があります。標本の期間、観察する時間帯、ゾーンの幅、到達の定義、反応の定義、初回接触と再接触の扱い、現在価格からの距離、そして水準の生成方法です。このうち一つでもずれていれば、観測された差はその項目の差を反映している可能性が残ります。
そろえないと距離を測ってしまう
ピボットの R2 は R1 より現在価格から遠い位置にあることが一般的です。単純に到達率を比較すれば R1 のほうが高くなりますが、これは R1 に固有の性質ではなく、距離が近いという性質です。同じことがフィボナッチ側にも起こります。押しの浅い水準は、深い水準より高い割合で到達します。比率そのものの性質を見たいのであれば、当日始値からの距離、ボラティリティに対する距離、到達までの時間といった条件をそろえた比較群を用意する必要があります。そろえないまま得た差は、水準の情報ではなく距離の情報です。
比較対象の作り方には、既存の実証研究に具体例があります。一様乱数で生成した人工的な支持線・抵抗線を大量に作る方法と、フィボナッチ水準から十分離れた位置に無作為のゾーンを置く方法です。どちらの研究も、対象、期間、統計手法が互いに異なります。二つの設計と報告値の完全な記述、および何を確立し何を確立していないかは、「二本の実証研究は、何を報告し、何を報告していないのか」に記載しています。
定義を先に決めないと、数字は何を測ることになるのか
定義が数字を作る
反応率という数字を決めているのは市場だけではありません。到達と反応の定義、観測窓の長さ、何度目の接触まで数えるか。これらを変えれば、同じ価格系列から別の反応率が出ます。だからこそ定義は結果を見る前に固定します。結果を見てから定義を選べる状態では、出てきた数字は市場の性質ではなく、定義の選び方を測ったものになります。
判定の緩さが数字を押し上げる
この点には、「二本の実証研究は、何を報告し、何を報告していないのか」で見た一次的な証拠があります。Tsinaslanidis らは、フィボナッチ押し水準に幅 ζ を持たせてゾーン化し、ζ を広げるほど反発と判定される確率が単調に上がることを示しています。ダウの銘柄では ζ = 0% で 49.08%、ζ = 6% で 73.23% です。重要なのは、著者自身がこの上昇の意味を否定していることです。著者は、これは自分たちが用いた反発と失敗の定義の非対称性から生じる機械的な効果であり、収益性の向上には結びつかないと明記しています。
同じ構造を Osler の研究も示しています。業者が公表した支持線・抵抗線での反発頻度は 60.8% と報告されていますが、著者自身が脚注で、反発の定義が非対称であるためにこの値は水準の性質を示さないと説明しています。対象と期間の詳細は「二本の実証研究は、何を報告し、何を報告していないのか」にあります。いずれの例でも、意味を持つのは絶対値ではなく、人工水準との差です。
事前登録が検証設計で持つ意味
事前登録とは、観察を始める前に測る対象と判定条件を書き出して固定することです。これは作法ではなく、数字が何を測ったものかを確定させるための必要条件です。固定すべき対象には、水準を生成した方式そのものも含まれます。「R1 に到達した」という記録は、どの計算方式の R1 かが書かれていなければ再現できません。方式が違えば同じ入力から別の価格が出ますし、方式によっては R3 以降が定義されていません。方式ごとの入力と確定タイミングの違い、つまり同じ名前の水準が方式によって別の価格になる原因は、ピボットの値が方式で違う理由が扱っています。
測定手順そのもの、すなわち登録する項目、許容距離の扱い、同じ入力から出た線を一つに畳む作業は、フィボナッチとピボットの重なりを二重計上せずに測る手順で扱います。本記事の側から言えるのは一点だけで、同じ入力から出た二本を二回数えたまま反応率を計算すれば、その分母は事例の数ではなく線の数を反映したものになります。
コストは、必要な勝率をどれだけ動かすのか
コストは必要勝率を押し上げる
取引コストは、期待値から一定額を引くだけでなく、損益分岐となる勝率そのものを動かします。
損益分岐勝率(コストを無視した場合)
  p = Lo ÷ (W + Lo) = 10 ÷ 30 = 0.3333 = 33.33%

損益分岐勝率(往復コスト 1.0 を含めた場合)
  p = (Lo + c) ÷ (W + Lo) = 11 ÷ 30 = 0.3667 = 36.67%
表示値の差は 3.34 ポイント、丸める前の差は 1 ÷ 30 で 3.33 ポイント台です。往復で 1.0 という平均利益の 20 分の 1 にすぎないコストが、必要な勝率を 3 ポイント以上押し上げます。目標とする値幅が小さいほど、この比率は大きくなります。
費用の範囲と、想定を変えたときの感応度
コストとして計上すべきものはスプレッドだけではなく、取引手数料、約定価格のずれ(スリッページ)、ポジションを持ち越す場合の金利相当分、注文から約定までの遅延、部分約定や約定拒否の影響、時間帯や指標公表前後のスプレッドの拡大が含まれます。過去データを用いた検証では、これらの一部が構造的に再現できません。固定スプレッドを前提とした集計は、実際には拡大していた時間帯の取引を実態より有利に評価します。
したがって、単一のコスト想定で計算した期待値を結論にはできません。コストを 1.5 倍、2 倍にしたときに何が残るかを併せて確認します。先の例では往復コストが 2.0 になれば期待値はちょうど 0 です。コストの想定が倍になるだけで結論が反転する結果は、コストの推定精度に全面的に依存しています。
引用した二つの研究はコストを扱っていない
本記事が引く二本の実証研究は、いずれも取引コストを扱っておらず、Osler はそもそも収益性を検証していません。各研究の対象、期間、報告値は「二本の実証研究は、何を報告し、何を報告していないのか」に記載しています。したがって、いずれからもコスト控除後に何が残るかを読み取ることはできません。
コストが扱われていないことが結論にどう効くかは条件によります。二つのルールの取引回数と回転率が同じなら、コストは両方から同じだけ引かれるため差の符号は変わりません。しかし片方が他方より多く売買する設計であれば、コストは多く売買する側から多く引かれ、差そのものが動きます。Tsinaslanidis らの研究は取引回数と回転率を比較群間で揃えたと述べていないため、コスト控除後にどうなるかは、この論文からは分かりません。比較を行うときは、コストの想定に加えて、比較する両者の取引回数と回転率が揃っているかを確認してください。
どこまでが「条件決定に使っていない期間」か
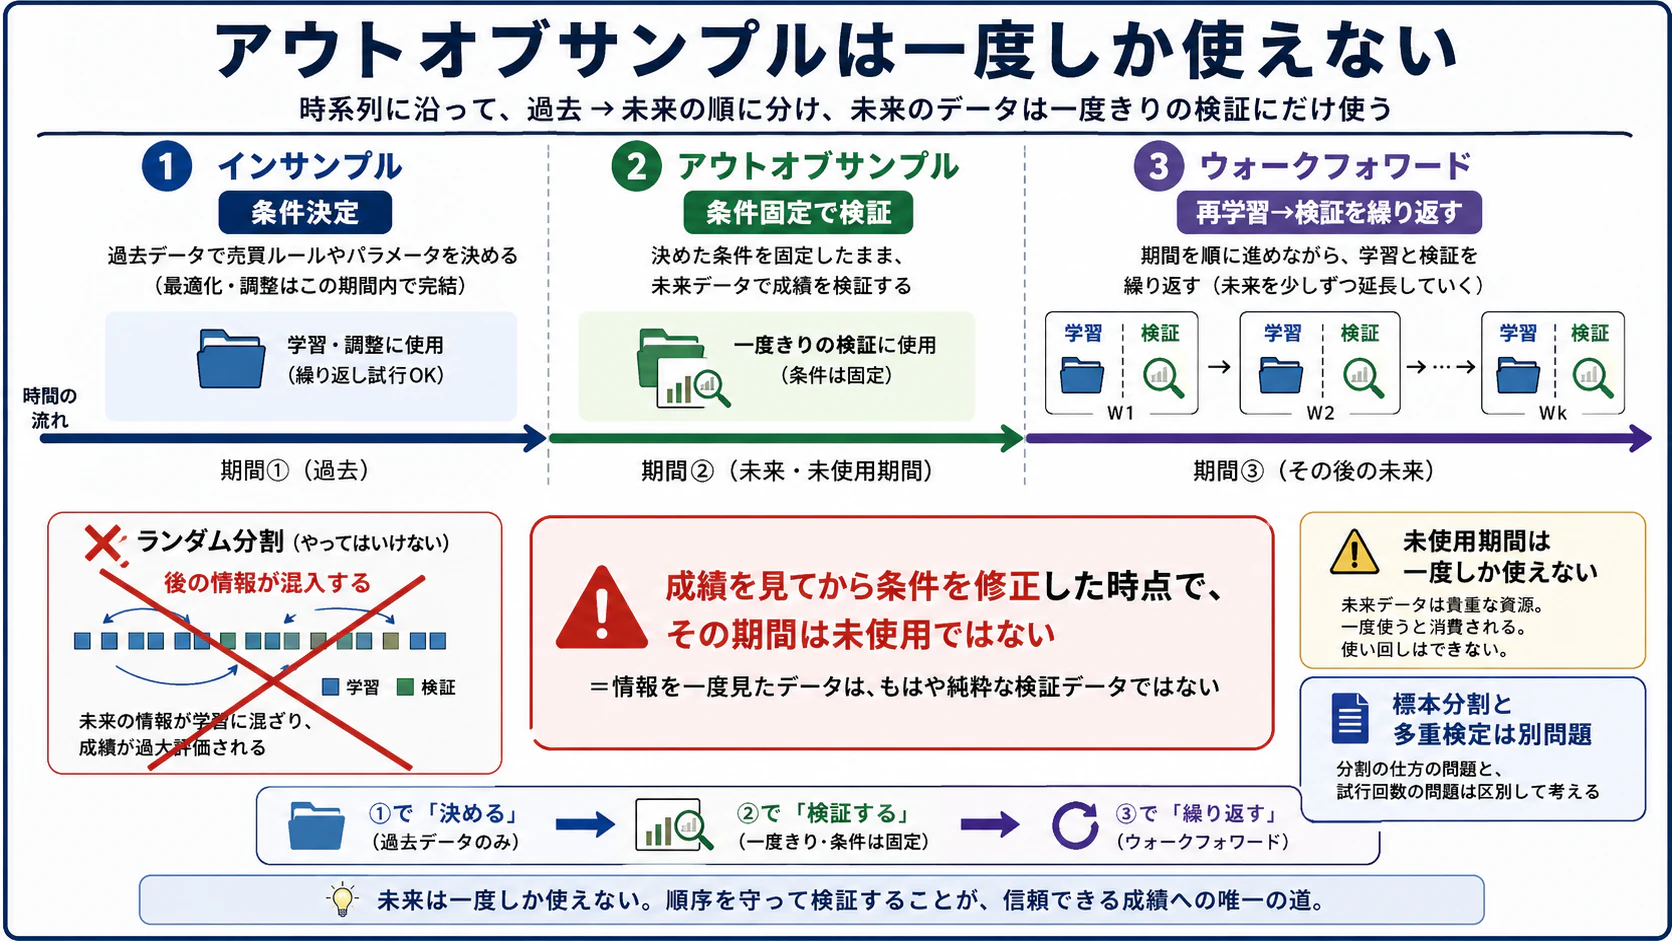
時系列順に分ける:一度きりの分割とウォークフォワード
条件を決めるために使う期間と、決めた条件を試す期間は分けます。以下も説明のための合成値です。
全 1,000 営業日を時系列順に分割

  インサンプル(IS)        700 日(70%)
  アウトオブサンプル(OOS)  300 日(30%)
分割は時系列順に行い、無作為抽出は使いません。日付を無作為に振り分けると、後の期間の情報が条件決定に混入します。市場の状態は連続しているため、同じ局面の一部が両側に入るだけでも未使用期間としての意味が失われます。同じ理由で、全期間から計算した集計値をその期間の一部の検証へ持ち込むことも避けます。
一度きりの分割では、条件を更新しながら運用する設計を評価できません。その場合はウォークフォワードを使います。
期間1 で条件を決定 → 期間2 で適用
期間1と2 で条件を再決定 → 期間3 で適用
期間1から3 で条件を再決定 → 期間4 で適用
各時点で、その時点までに利用可能だった過去データだけを使います。ただし、更新の頻度、各区間の長さ、再決定に使う評価基準は、いずれも設計者が選ぶ項目です。
未使用期間は一度しか使えない
アウトオブサンプルの性質は、統計的な処理ではなく手続きによって与えられています。したがって、成績を見てから条件を修正した時点で、その期間は条件決定に使われたことになり、もはや未使用ではありません。修正の大小は関係しません。変更の根拠がその期間の成績である以上、その期間は開発に使われています。ウォークフォワードの更新頻度や区間長を結果を見ながら選ぶ場合も同じで、全体が一つの最適化になります。
期間を分けたからといって、多数の条件を試したことの影響が消えるわけでもありません。標本の分割と、次に述べる多重検定の扱いは、別々に対処すべき二つの問題です。
何通り試したかを数えないと、何が起きるのか
試行回数が増えると偽陽性はほぼ確実になる
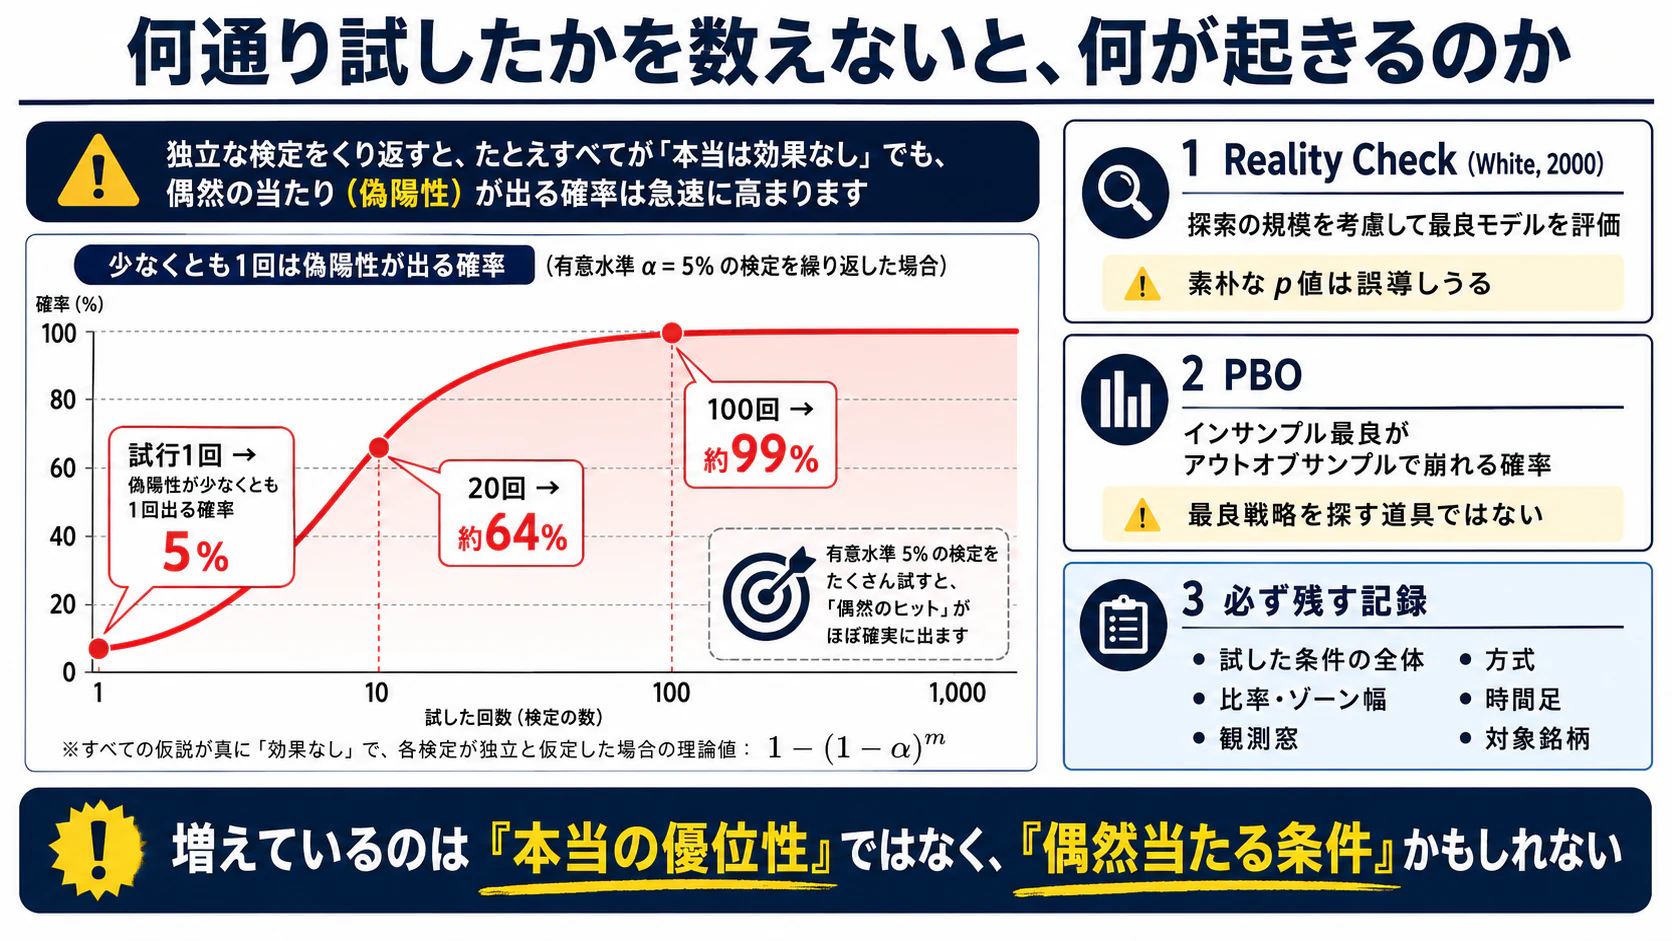
有意水準を 5% に置けば、真には何の関係もない条件でも 20 回に 1 回は有意な結果が出ます。試行を重ねるほど、少なくとも1回「有意」が出る確率は急速に上がります。
有意水準 5%、独立した 20 回の試行
  1 回以上の偽陽性が出る確率 = 1 − 0.95^20 = 0.642 = 64.2%

同じ条件で独立した 100 回の試行
  1 − 0.95^100 = 0.994 = 99.4%

Bonferroni 調整による水準
  0.05 ÷ 20 = 0.0025
この計算は各試行が独立であることを前提としており、近接した条件どうしは強く相関するため数値は目安ですが、試行が増えるほど偽陽性が避けがたくなる方向は変わりません。フィボナッチとピボットの検証では、比率、ゾーン幅、反発幅と失敗幅、観測窓、ピボット方式、基準期間、時間足、対象銘柄を組み合わせれば数千から数万通りの条件が作れます。その中の最良の一つは、過去の値動きに最もよく合った条件であって、水準の性質を示した結果ではありません。
データスヌーピングの扱い
この問題を正面から扱った一次資料が White (2000) です。同論文はデータスヌーピングを、与えられたデータ集合を推論またはモデル選択の目的で2回以上使用すること、と定義し、検定すべき帰無仮説を、特定の探索の中で遭遇した最良のモデルが所与のベンチマークに対して予測上の優位性を持たない、という形に置きます。数式では max_k E(f_k*) ≤ 0 と書かれます。手続きとしては、モデルとベンチマークの相対性能の系列を stationary bootstrap で再標本化し、最良モデルの統計量をその分布と比較します。実例として、S&P500 の日次リターンの1日先予測が示されています。29 の指標から3つを選ぶ線形モデルを 3,654 通り作り、ベンチマークは定数項のみのモデルとしたものです。
方向的中率を基準とした場合
  最良モデル          54.75%
  ベンチマーク        50.79%
  素朴に計算した p 値      0.0036
  Reality Check の p 値    0.2040

予測誤差を基準とした場合
  素朴に計算した p 値      0.1068
  Reality Check の p 値    0.3674
方向的中率で見れば最良モデルはベンチマークを 4 ポイント近く上回り、素朴な p 値は 0.0036 ですが、探索の規模を考慮した Reality Check の p 値は 0.2040 で、帰無仮説は棄却できません。著者は、素朴な p 値に依拠する者は深刻に誤導されると述べ、両者の差がデータマイニングによるバイアスの直接的な推定値を与えると説明しています。
前提について、誤解されやすい点を1つ挙げます。同論文は、モデル集合を事前に固定せよとは要求していません。むしろ、逐次的にモデルを追加していく探索に適用できることを、この手法の利点として述べています。前提として明示されているのは、モデルが有限個であること、ベンチマークを事前に特定すること、および系列に関する定常性と混合条件です。したがって「探索を始める前にすべての候補を書き出さなければ使えない」という理解は、この論文の要求とは異なります。
過剰最適化の確率(PBO)とその限界
もう一つの一次資料が、Bailey, Borwein, López de Prado & Zhu によるバックテスト過剰最適化の確率(PBO)です。PBO は、インサンプルで最良と選ばれた設定が、アウトオブサンプルでは N 個の設定の中央値を下回る確率として定義されます。原論文の定義節は中央値を用いており、結論部にのみ平均という表記のゆれがありますが、ここでは定義節に従います。
推定にはCSCV という手続きが使われます。損益の系列を偶数 S 個の区間に分割し、そのうち S/2 個を訓練に、残りを検証に割り当て、可能な組合せをすべて走らせます。訓練と検証が等サイズかつ対称であること、時系列の順序を保つこと、そして同じ入力に対して常に同じ結果を返すため第三者が再現できることが、この構成の特徴です。
原論文は、この手法の限界を独立した章として設けています。
- この手法はバックテストの正しさを一切評価しません。取引コストの設定が誤っていたり、判断時点では入手できなかったデータを使っていたりすれば、歪んだ情報に基づいて評価を返すだけである、と原論文が明記しています。
- 試した全ての試行を開示しなければなりません。一部を隠して計算すれば、過剰最適化の程度を過小評価することになります。
- この手法を最良の戦略を探す道具として使ってはなりません。原論文はこれを重大な誤用とし、いかなる過剰最適化対策も、戦略選択の目的関数にすればその指標に対する過剰最適化を生むと述べています。
なお、PBO が 0.05 を超えるモデルは棄却する、という記述が広まっていますが、原論文はこれを条件法で、慣例的な方法だろうという形で述べているにとどまります。規範として断定されたものではありません。本記事もこれを判定基準として提示しません。
試した条件の全体を記録する
以上から、実務上の要件が定まります。最終的に採用した条件だけでなく、上に挙げた条件の全体、除外した条件、そして最良を選ぶときに使った基準を記録し、開示することです。本記事は、試行回数から必要な標本の長さを算出する換算は示しません。
なお、パラメーターを少し動かしたときに成績が崩れるかどうかを見る作業は、記録の読み方として有用です。ある一点だけが突出して良く、その両隣で崩れる結果は、過去の値動きへの適合を疑う手がかりになります。ただしこれは判定の規則ではありません。
その点推定には、どれだけの幅があるのか
点推定には幅がある
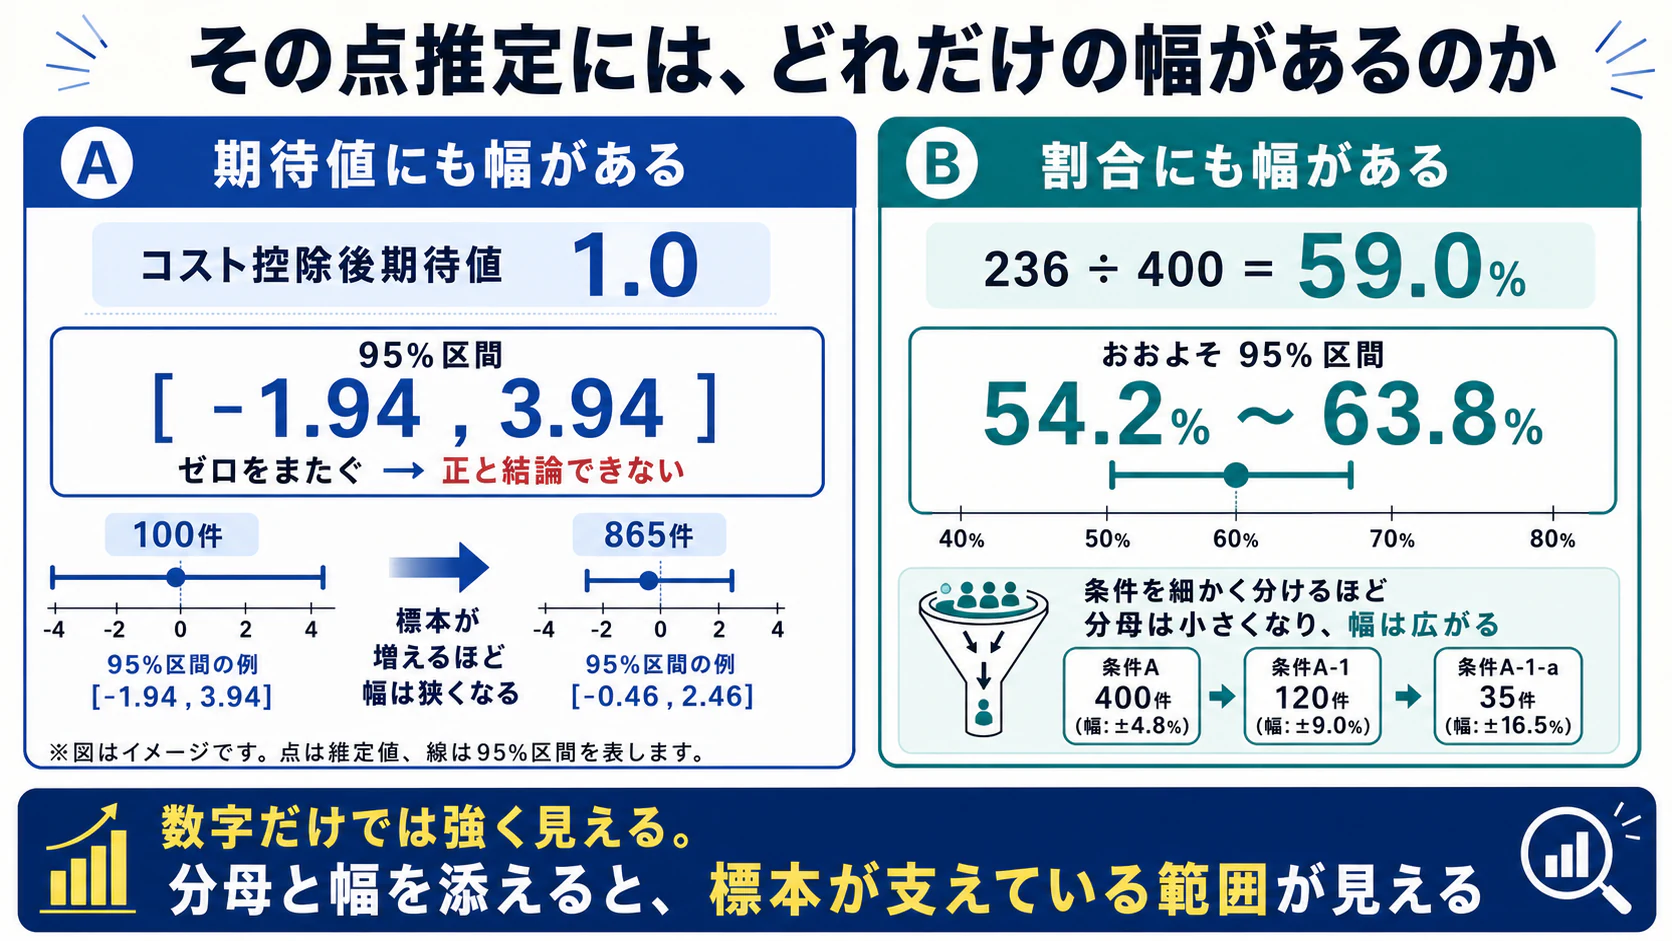
コスト控除後の期待値 1.0 という数字は、点推定です。同じルールを別の 100 件の取引に適用すれば、別の値が出ます。したがって、幅を併記しなければ何も言ったことになりません。
コスト控除後の1取引あたり期待値   E_net = 1.0(「勝率と期待値は取引を分母にする」で求めた値)
1 取引あたりの標準偏差            15
取引件数                          100

標準誤差 = 15 ÷ √100 = 1.50
95% 区間 = 1.0 ± 1.96 × 1.50 = [ −1.94, 3.94 ]
区間はゼロをまたぎます。100 件の記録では、この期待値が正であると結論することはできません。区間がゼロをまたがなくなる取引件数を、同じ標準偏差のもとで逆算します。
1.96 × 15 ÷ √n < 1.0 を満たす最小の n

  n = 864 のとき  1.96 × 15 ÷ √864 = 1.00021 (条件を満たさない)
  n = 865 のとき  条件を満たす
同じ 1.0 という平均でも、100 件の記録と 865 件の記録では意味が違います。ただしこの計算は、1 取引ごとの損益が独立で同じ分布に従い分散が有限であるという近似に依っており、標準偏差 15 それ自体も標本からの推定値です。実際の売買記録は分布が偏り、時間的に相関することがあります。この n は目安であって、達成すれば結論が確定する境界ではありません。
割合にも幅がある
同じことが反応率にも当てはまります。236 ÷ 400 = 59.0% も点推定であり、幅を持ちます。条件を細かく分けるほど分母は小さくなり、年度別・時間帯別・方向別に分ければ、全体で 400 件あった事例が各区分では数十件になって、幅は急速に広がります。
区間推定の方法、条件付き割合の分母設計、到達と支持・抵抗で分母がどう変わるかという計算は、フィボナッチゾーンの条件付き到達割合と分母の設計が扱います。本記事で確定できるのは、割合には必ず分母と幅を併記する、という点までです。
以上を踏まえると、報告の形式は自然に決まります。「期待値は 1.0 だった」ではなく、「この標本 100 件において、コスト控除後の1取引あたり平均は 1.0、95% 区間は [ −1.94, 3.94 ] であり、正であると結論するには標本が不足している」と書きます。「反応率は 59.0%」ではなく、「事前に定義した到達 400 件のうち、反応条件を満たしたものが 236 件、割合は 59.0%」と書きます。数字だけを取り出せば強い主張に見え、分母と幅を添えれば弱い主張に見えますが、後者がその標本の実際に支えている内容です。
引用した方法論の論文は、何についての出典か
本記事は、実証研究のほかに三本の論文を引いています。これらは、対象そのものの評価ではなく、評価の仕方についての出典です。混同されやすいので、使用の範囲をここで区切っておきます。
White (2000) と Bailey らの論文は、フィボナッチやピボットについての証拠ではありません。多数の条件を試したときに結果をどう評価するか、という方法についての出典です。Reality Check の p 値が示した S&P500 の実例は、テクニカル指標一般の有効性についての結論ではなく、探索の規模を考慮しない評価がどれだけ誤導的になりうるかを示す例示です。PBO とCSCV も同様に、評価の枠組みであって、対象そのものの評価ではありません。
もう一つ、確率の言明を出す設計を採る場合にだけ必要になる道具があります。Brier (1950) は、その最初期の定義を与えた気象予報の論文です。スコアは P = (1/n) Σ_j Σ_i (f_ij − E_ij)² と定義され、n は予報の機会数、f_ij は予報された確率、E_ij は実現したときに 1、しなかったときに 0 を取ります。原論文における値域は 0 から 2 であり、小さいほど良く、0 が完全な予報です。現代の実務で 0 から 1 と説明されるのは、二値の場合に片方のクラスだけを合計する後年の変形であり、原典の定義とは範囲が異なります。
著者が適用条件として明示しているのは二点です。予報が確率の言明として表現されていること、そしてクラスが相互排他的かつ網羅的で、確率の和が 1 になることです。これは気象予報についての論文であり、金融市場への適用条件は一切論じられていません。
したがって本記事では、この道具を「確率の言明を実際に出したときに初めて使えるもの」として位置づけるにとどめます。
確定したことと、確定していないこと
本記事が確定したのは、測り方の設計です。四段の指標を分けて分母と事象を添えること、比較対象を同じ条件で作ること、定義を結果より先に固定すること、コストを全範囲で見積もって感応度を見ること、標本を時系列順に分けること、試行の全体を記録して探索の規模を考慮すること、そして点推定に幅を併記することの七点です。
確定していないことも明示します。特定の比率や水準に他の価格帯を上回る性質があるか、許容幅と反応の定義をいくつに置くのが妥当か、コストを差し引いた後に何が残るか。これらはいずれも本記事が答えを出す問いではありません。示したのは、これらに答えようとするとき何をどう測れば答えが意味を持つか、という設計の側だけです。
最後に、道具との関係を一点だけ述べます。プラットフォームには、売買ルールを過去データへ当てて成績を自動で集計する機能が備わっていることがあります。こうした機能が返すのは、利用者が指定した条件での集計結果です。集計が自動化されていることは、その集計の設計が妥当であることを意味しません。比較群を置いたか、事象の定義を結果より先に固定したか、何通り試したかを数えているか、標本を時系列順に分けたか、コストをどう見積もったか、観測どうしの依存をどう扱ったか。これらはいずれも利用者が決める事柄であり、自動計算の対象ではありません。本記事が扱っているのは、この設計の側だけです。
そして、ここまでの手順をすべて満たした検証結果であっても、それは過去の記録に対する評価です。将来の成績を示すものではなく、将来の成績として提示することもできません。
次に読む記事
- 検定の対象そのものを特定したい場合は、ピボットの値が方式で違う理由へ。同じ「R1」でも実装ごとに別の価格になる原因を、出典・入力・確定タイミング・丸めの四つに分けて扱っています。
- 記録の取り方から始めたい場合は、フィボナッチとピボットの重なりを二重計上せずに測る手順へ。同じ入力から出た二本を一つに畳む手順を扱っています。
- 分母の設計と区間推定へ進む場合は、フィボナッチゾーンの条件付き到達割合と分母の設計へ。到達と支持・抵抗で分母がどう変わるか、標本が薄いときに区間がどこまで広がるかを計算例で扱っています。
使う前に確認しておくこと
本記事は、テクニカル分析の検証設計に関する一般的な情報を提供するものであり、特定の商品、通貨ペア、売買方法、業者、プラットフォーム、自動売買プログラムを推奨するものではありません。掲載した数値は、引用した研究の報告値を除き、すべて説明のための合成値です。ここで扱った水準はいずれも観察の候補であり、価格の方向を決めるものでも、反発や到達を保証するものでもありません。過去のデータに基づく検証結果は、将来の成績を示すものではありません。実際の判断は、ご自身の責任において行ってください。
どの比率やどの水準が有効かという結論は出しておらず、フィボナッチやピボットが有効であるとも無効であるとも述べていません。参入や退出、注文の置き場所、数量といった売買の設定、および特定の指標そのものの推奨も行っていません。
参照した情報
各論文の対象、期間、比較群、報告値は本文に記載しています。ここでは書誌情報と、本記事における使用境界を示します。
- Carol Osler, Support for Resistance: Technical Analysis and Intraday Exchange Rates. FRBNY Economic Policy Review, Vol.6 No.2, July 2000, pp.53-68. 本記事はこの論文を、「二本の実証研究は、何を報告し、何を報告していないのか」に記載した市場・時間足・期間・検証対象・比較群・報告値および期間依存性の各事項の根拠として用いています。フィボナッチ水準の有効性、計算式から求めるピボットの有効性、取引コスト控除後の収益性、他市場・他時間足への一般化の根拠としては用いていません。同論文は収益性を検証しておらず、著者は結論部でそれを今後の研究の主題としています。
- Tsinaslanidis, Guijarro & Voukelatos, Automatic identification and evaluation of Fibonacci retracements: Empirical evidence from three equity markets. Expert Systems with Applications, Vol.187, 2022, article 115893. DOI 10.1016/j.eswa.2021.115893 本記事はこの論文を、同じ節に記載した対象・期間・検証対象・比較群・統計手法・報告値、および著者自身の留保の根拠として用いています。為替、日足以外の時間足、他指標との併用、異なる高値・安値の判定規則についての根拠としては用いていません。同論文は取引コストを扱っておらず、本文に該当する語が出現しません。コストが結論にどう効くかについて本記事が述べているのは、比較する両者の取引回数と回転率が揃っているかどうかで変わる、という条件付きの記述だけです。それは当サイトによる整理であり、著者の論述ではありません。
- Halbert White, A Reality Check for Data Snooping. Econometrica, Vol.68 No.5, September 2000, pp.1097-1126. DOI 10.1111/1468-0262.00152 本記事が本文を確認したのは出版社版ではなく、大学の講義ページがホストする同一論文の版です。正式な引用は上記の DOI によります。 本記事はこの論文を、データスヌーピングの定義、帰無仮説の形、手続き、本文に記載した実例の各数値、および前提条件の根拠として用いています。フィボナッチやピボットの有効性についての根拠としては用いていません。同論文はモデル集合を事前に固定することを要求しておらず、逐次的にモデルを追加する探索への適用を利点として述べています。
- Bailey, Borwein, López de Prado & Zhu, The Probability of Backtest Overfitting. The Journal of Computational Finance. DOI 10.21314/JCF.2016.322 本記事はこの論文を、PBO の定義、CSCV の構成、および原論文が独立の章として明示する限界の根拠として用いています。PBO の閾値を判定基準として提示する根拠、および試行回数と必要標本長の定量関係の根拠としては用いていません。0.05 という閾値は、原論文が条件法で慣例的な方法だろうと述べているものです。
- Glenn W. Brier, Verification of Forecasts Expressed in Terms of Probability. Monthly Weather Review, Vol.78 No.1, January 1950, pp.1-3. 本記事はこの論文を、確率予測の検証スコアの定義式、原論文における値域が 0 から 2 であること、および著者が明示する適用条件2点の根拠として用いています。金融市場への適用可能性、およびテクニカル水準の有効性についての根拠としては用いていません。同論文は気象予報を対象としており、金融への適用条件を論じていません。
本記事の数値例は、引用した学術研究の報告値を除き、すべて説明のために作成した合成値です。計算は丸める前の値で行い、表示のみ丸めています。実在の銘柄や期間の成績ではなく、将来の成績を示すものでもありません。
最新の取引条件・手数料・キャンペーン等は、必ず各社公式サイトでご確認ください。本ページの情報は作成時点のものです。